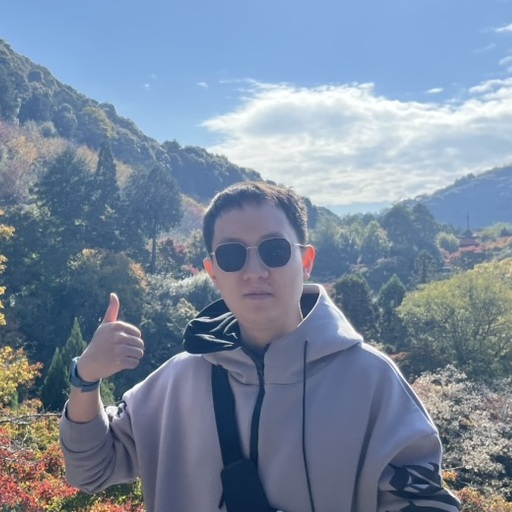
我越来越觉得,以论文为核心的那套评价体系,已经不足以评价一个人了。一个人做过的项目、想过的问题、长期投入的兴趣,可能更能说明他是谁。之后我会把更多兴趣与项目的内容更新到这个主页上。
📖 教育经历
华中科技大学 — 武汉
2019 年 9 月 - 2026 年 6 月,控制科学与工程博士,人工智能与自动化学院,师从罗云峰教授。
研究方向:大语言模型、强化学习、博弈论。
🧑💼 工作经历
字节跳动 Seed — 豆包大模型后训练(2026 年 7 月 ~ 至今)
在字节跳动 Seed 团队从事豆包大模型的后训练工作。聚焦于通过 SFT、RLHF / RLAIF 以及面向推理的奖励建模等方法持续提升模型的对齐质量与综合能力,目标是进一步增强豆包在指令跟随、复杂推理与工具使用等方向上的表现。
📝 学术论文
- Preference-CFR Beyond Nash Equilibrium for Better Game Strategies. (ICML 2025) 提出偏好反事实遗憾最小化算法(Pref-CFR),通过引入偏好与脆弱性参数实现多样化的纳什均衡求解,可在不损失策略强度的前提下定制不同风格的策略,并在德州扑克中展示了不同的打法风格。
- Accelerating Nash Equilibrium Convergence in Monte Carlo Settings Through Counterfactual Value Based Fictitious Play (NeurIPS 2024). 提出基于反事实值的蒙特卡洛虚拟对弈算法(MCCFVFP),在德州扑克等大规模复杂博弈中相比传统 MCCFR 收敛速度提升 20–50%。
- Real-Time Weighted Fictitious Play: Converging to Equilibrium at the Speed of $O(T^{-1})$ in Games. 提出实时加权虚拟对弈算法(RTWFP),在两人零和博弈中实现 $O(T^{-1})$ 的收敛速度,并扩展到相关均衡及连续时间 FP,在可扩展性与速度上均优于现有算法。
- ELO-Rated Sequence Rewards: Advancing Reinforcement Learning Models. 提出基于 ELO 评级的序列奖励方法(ERRL),使用序数偏好与 ELO 评分替代传统数值奖励,在 Atari 等长程强化学习任务中取得领先性能。
💻 实习经历
字节跳动 Seed — 基于博弈的大模型后训练(2025 年 6 月 ~ 2025 年 10 月)
- 项目目标:将博弈论问题引入大语言模型的后训练流程,提升 LLM 能力上限。
- 项目成果:交付了面向博弈场景的 LLM 评估框架与训练框架;训练出的德州扑克 LLM AI 在指令遵循能力提升的同时,整体表现优于 GPT-o3、Grok-4 等模型。
- 个人工作:提出了一种带有 "LLM Reflection" 机制的新算法,在博弈场景中优于传统强化学习方法;搭建了面向博弈的 LLM 评估框架(已集成进团队体系)以及基于 Verl 的训练框架。
vivo — 基于强化学习的 Stable Diffusion 模型微调(2025 年 2 月 ~ 2025 年 4 月)
- 项目目标:使用强化学习对 Stable Diffusion 进行微调,提升生成质量与提示词对齐效果。
- 项目成果:初步结果显示生成图像在质量、文本相关性以及与人类偏好的对齐上均有明显提升,正在持续优化奖励设计与扩大分布式训练规模。
- 个人工作:设计了融合美学评分、文本相关性、多样性与人类反馈的复合奖励模型,并调优了 SD 的强化学习训练链路。
Fen AI — 德州扑克 AI(2023 年 9 月 ~ 2024 年 1 月)
- 项目目标:打造一款对标 Pluribus(业内知名德州扑克 AI)水平的 AI。
- 项目成果:最终 AI 在两人德州扑克中达到了职业玩家水平,多人德州扑克 AI 仍在持续开发中。
- 个人工作:参与核心算法的研发(如 MCCFR、MCCFR pruning),搭建了策略存储与结果可视化等基础组件,并负责算法的参数调优与测试。
字节跳动朝夕光年 — 强化学习实习(2021 年 7 月 ~ 2022 年 3 月)
- 项目目标:为游戏《航海王:燃烧意志》设计多风格 AI 陪玩 NPC。
- 项目成果:在原有 AI 训练框架之上加入风格演化模块,核心指标提升 80–120%,并在玩法风格上形成清晰区分,部分 AI 已达到可上线水平。
- 个人工作:作为该项目的主要执行者,在导师指导下实现了多风格 AI 算法,并探索了人类偏好与强化学习相融合的方法,最终沉淀为一篇总结研究发现与潜在应用的研究论文。
华润集团 — 土地竞拍(2021 年 2 月 ~ 2021 年 6 月)
- 项目目标:为华润集团设计 “首/末” 类型土地竞拍中的报价策略。
- 项目成果:该策略获华润置地集团认可,并在数十宗(每宗超 1 亿美元)的土地竞拍中部署。算法表现优于集团专家方案,报价精度提升 3–4 倍,中标概率提升约 5%,最终被采纳为集团标准土地竞拍策略。
- 个人工作:基于历史竞拍数据搭建 “首/末” 类竞拍仿真环境,使用 Fictitious Play 算法开发竞价策略;亲历 3 次真实竞拍,总报价规模约 10 亿美元,并据此持续打磨模型。
📝 最新博客
给《钢铁雄心 3》的黑冰做了一个中文版
一千多个小时的游戏,一个搁了很多年的念头:要是黑冰有中文就好了。2026 年我把它做出来了——95.8% 的文本、一个只认 8 位字形的引擎,和一句覆盖了寄存器的汇编。
如果让一群 AI 证明数学定理,我们需要设计一家怎样的“公司”?
当大量 AI Agent 共同研究一个数学问题,真正稀缺的不再只是生成思路的能力,而是组织、验证、通信与人类监督。本文尝试设计一套以 Claim、证明、反例和审查为核心的 AI 数学研究所。
🎮 兴趣爱好
下面这些爱好不只是「玩」:偶尔我也会为它们做点东西。最大的一次「跑偏」,是给一款从高中玩到现在的策略游戏做了中文版。
黑冰中文版 · Black ICE Chinese —— 钢铁雄心 3 黑冰 MOD 汉化整合
一个免费、非盈利的玩家项目:把 Black ICE(《钢铁雄心 3》体量最大的英文 MOD)和《钢铁雄心3 TFH 402 汉化第三版》整合成一个中文版,目标是「打开就是中文,能从头玩到尾」。
- 为什么做: 高中、本科、研究生三个阶段我都在玩 HOI3,前后一千多个小时,最喜欢的始终是黑冰:补给是硬的,工业是真要算的,一个装甲军的编制能研究一下午。但我英语撑不住它的阅读量——玩三个小时,两个小时在查词。
- 做了什么: 原版引擎只认 8 位字形,中文根本显示不出来。项目改了
hoi3_tfh.exe:把字形读取从 8 位扩到 16 位(42 处补丁点 + 8 KB 新增代码段),修掉一个必定触发的0xC0000005崩溃(一句mov cl,[edx+eax]覆盖了调用者的ecx),并打开 4 GB 地址空间,避免后期大地图内存不足。 - 做到什么程度: 本地化文本 80,195 / 83,751 条,覆盖率 95.8%;将领姓名、部队番号、内阁部长均 100%。武器型号和规格故意保留英文。
- 顺带: 这也是一个可以核对的人机协作样本:用了什么工具、花了多少时间、烧了多少 token,都写在仓库的
ABOUT.md里。
🌱 关于我
性格开朗乐观,喜欢迎接有挑战性的任务。生活中热爱围棋、电子游戏和足球。
- 围棋:野狐围棋业余 7 段水平。
- 游戏:长期挚爱《星际争霸 II》,曾经达到国服(中国)大师段位。
- 足球:铁杆多特蒙德球迷,最喜欢的球员是马尔科·罗伊斯(Marco Reus)。
人生的一个巧合是:我喜欢的几乎所有东西——围棋、星际争霸、足球——都先后成为了 DeepMind 的研究对象。这个巧合也是我深信 AI 力量的原因之一。我的目标是基于大语言模型,通过 强化学习、博弈论与多智能体系统 的结合,在研究与产业落地两个维度推进 AGI 的前沿。